RAG documentale per un'azienda industriale
Normative, procedure HSE, documenti di sicurezza e operations raccolti in un archivio unico, interrogabile in linguaggio naturale e con accessi per ruolo, per un'azienda industriale con oltre 30 milioni di fatturato.
- Documenti indicizzati
- 225 GB
- Archivi riuniti
- 4
- Risparmiati per ricerca
- 23 min
- Alla messa in produzione
- 4 mesi
Il punto di partenza
La conoscenza dell'azienda c'era tutta, divisa in quattro archivi: 20 GB di documentazione HSE in circa 30.000 file, 5 GB di sicurezza, 150 GB di operations e altri 50 GB di documenti. Trovare quello che serviva voleva dire sapere in quale archivio cercarlo.
Una persona ci dedicava circa tre ore al giorno: una decina di ricerche su normative, documenti di tracciabilità e HSE, da 15 a 30 minuti ciascuna, spesso per rispondere a una richiesta esterna.
- RAG
- 5 su 5
- Backend
- 4 su 5
- Security
- 5 su 5
- UX/UI
- 3 su 5
- AI/ML
- 4 su 5
Il problema riscontrato
Organizzare la conoscenza e renderla fruibile. Normative, documenti di sicurezza e procedure HSE dovevano arrivare in fretta a chi ne ha bisogno, e soltanto a chi può vederli.
Lo stack
 Node.js
- Fastify
- LanceDB
- Mastra
Come abbiamo lavorato.
- 01
Un archivio solo
I quattro archivi, HSE, sicurezza, operations e il resto, confluiscono in un'unica base in LanceDB. La ricerca è ibrida, BM25 per i termini esatti come il numero di una norma e vettori per il significato, così una domanda trova il documento anche quando non ne usa le parole.
- 02
La domanda in linguaggio naturale
La ricerca è agentica. Chi cerca scrive la domanda con parole sue, e l'agente interroga l'archivio per rispondere.
- 03
Chi vede cosa
Accessi e ruoli stabiliscono quali documenti ciascuno può consultare, e quindi da quali documenti l'agente può rispondergli.
- 04
I file, non solo i frammenti
Oltre ai frammenti indicizzati e ai vettori, il sistema conserva i documenti originali e all'occorrenza fa da archivio di file.
Caratteristiche sotto esame
Focus su funzionalità e soluzioni
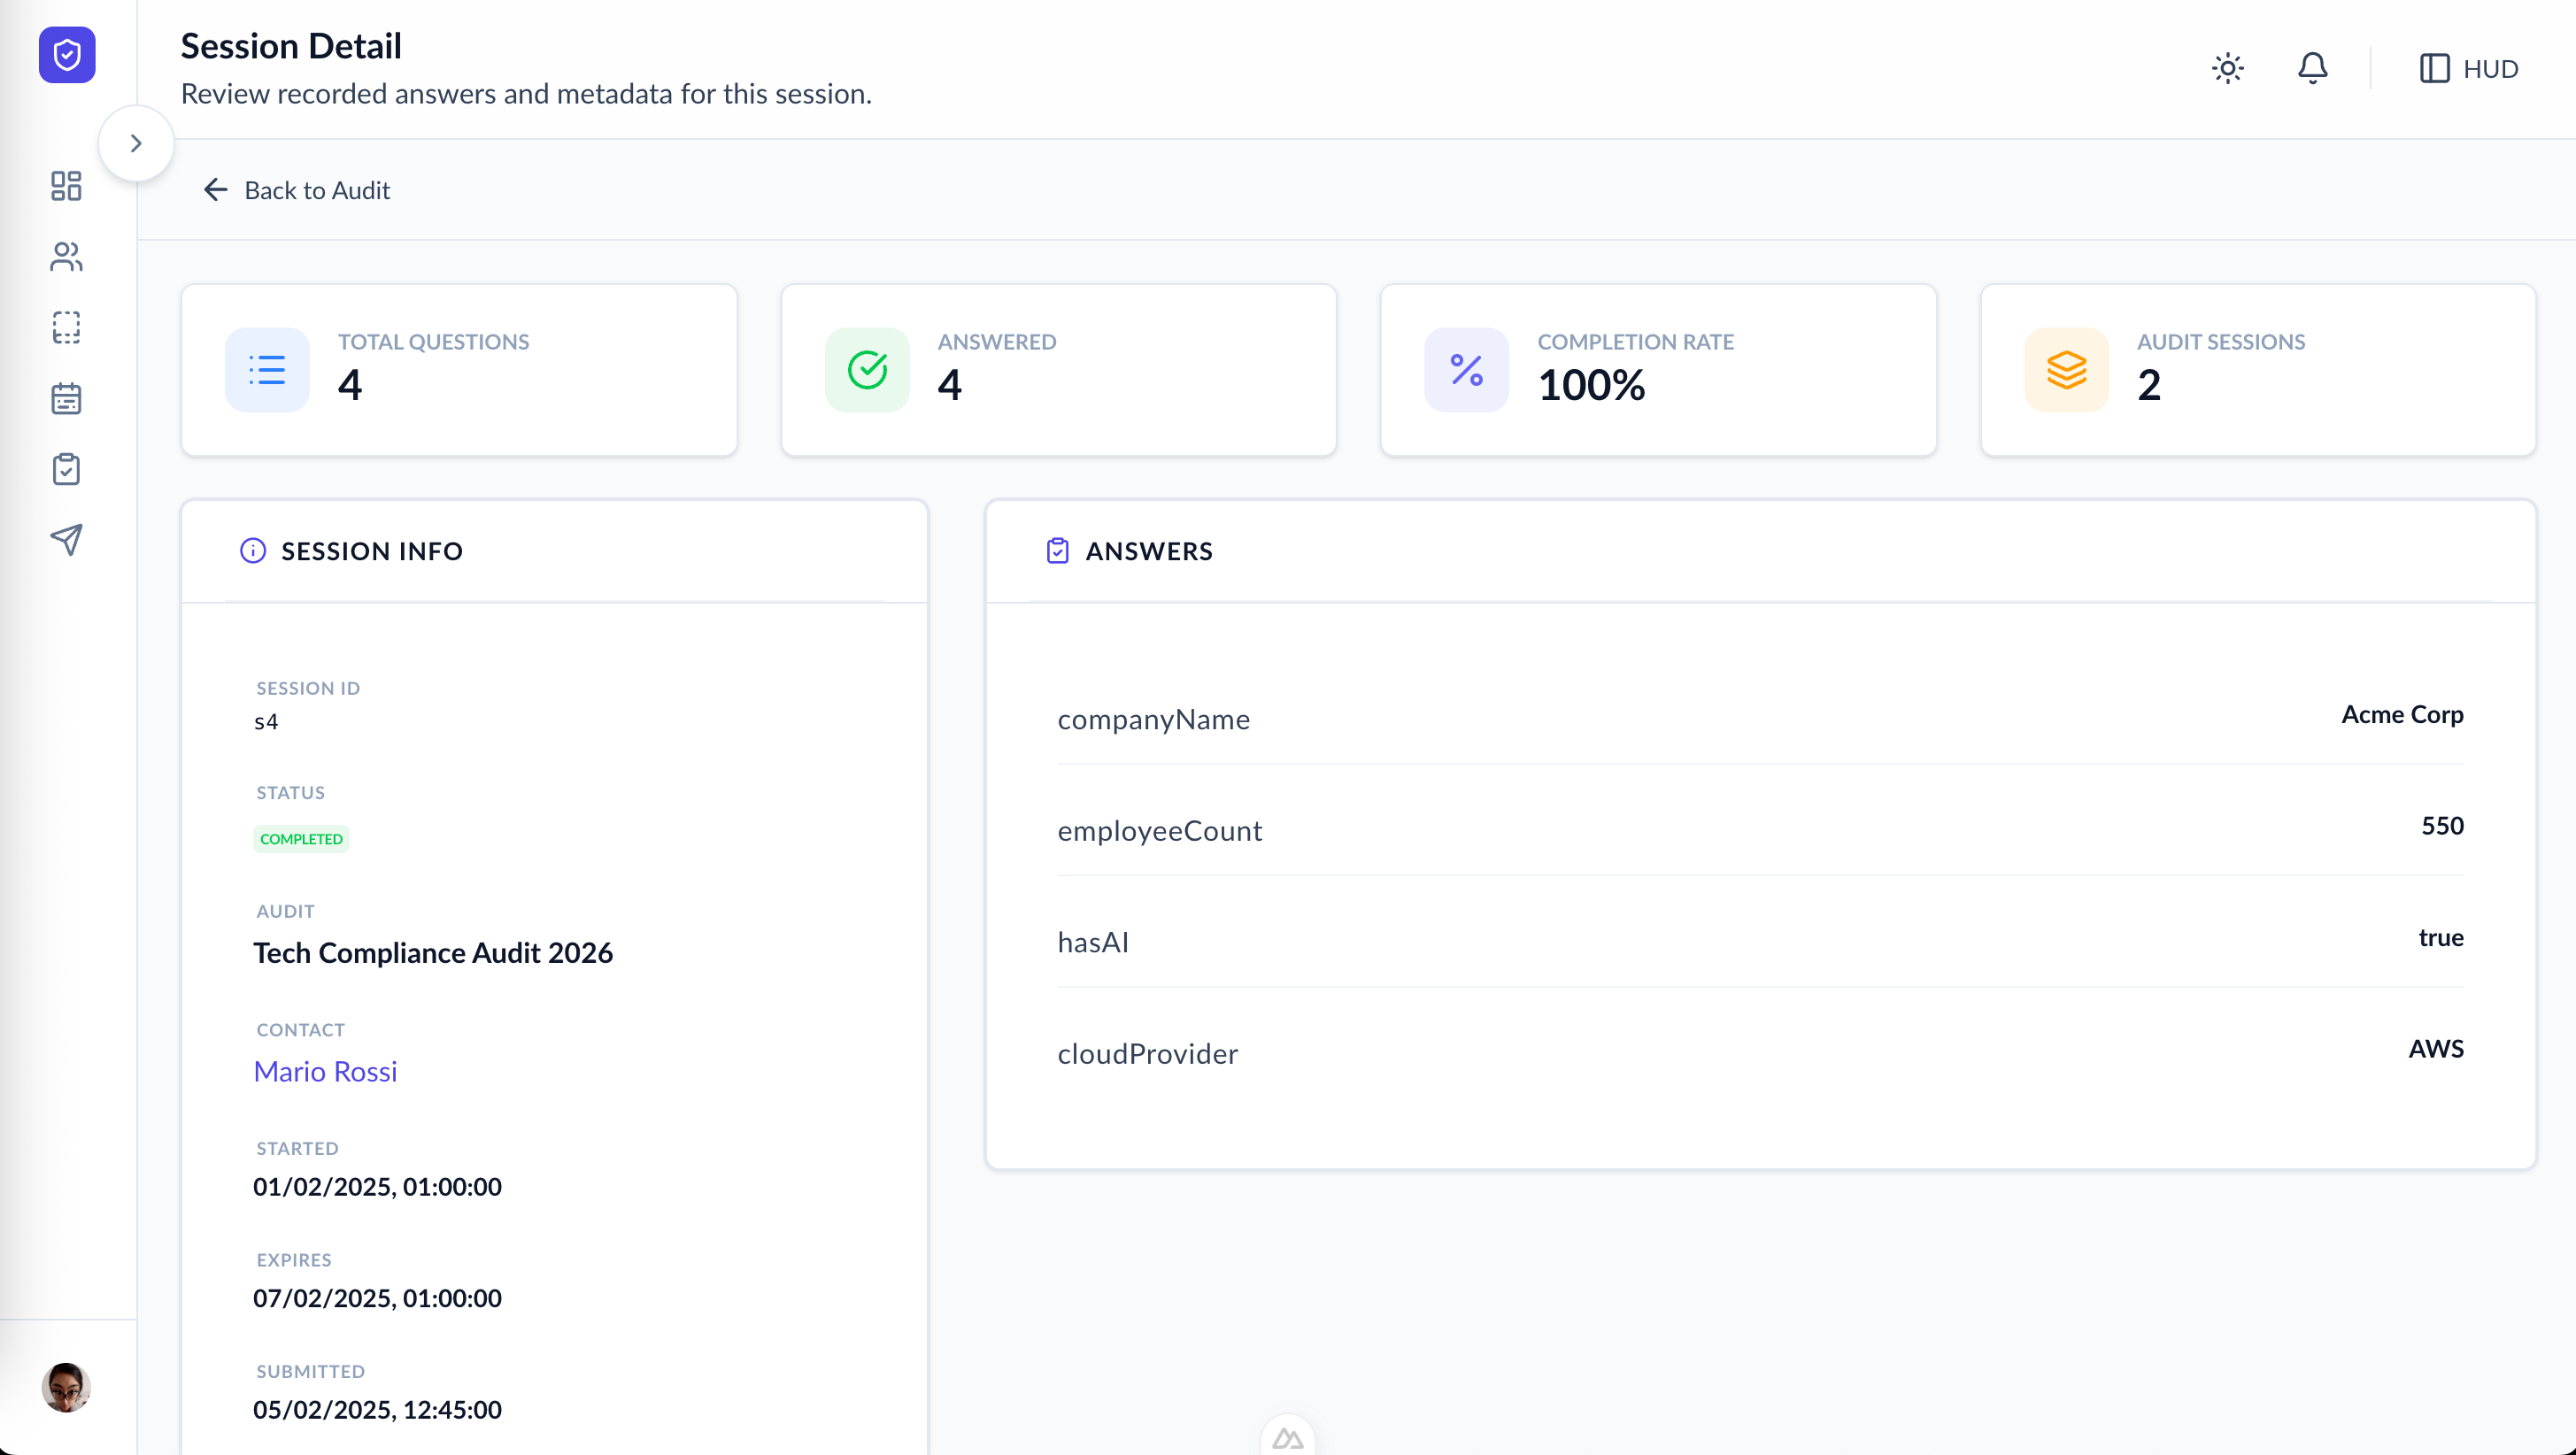
Una domanda, i documenti giusti
Chi cerca non deve sapere in quale archivio sta una procedura o come si chiama il file. Scrive la domanda, e l'agente la cerca in tutto quello che il suo ruolo gli permette di vedere.
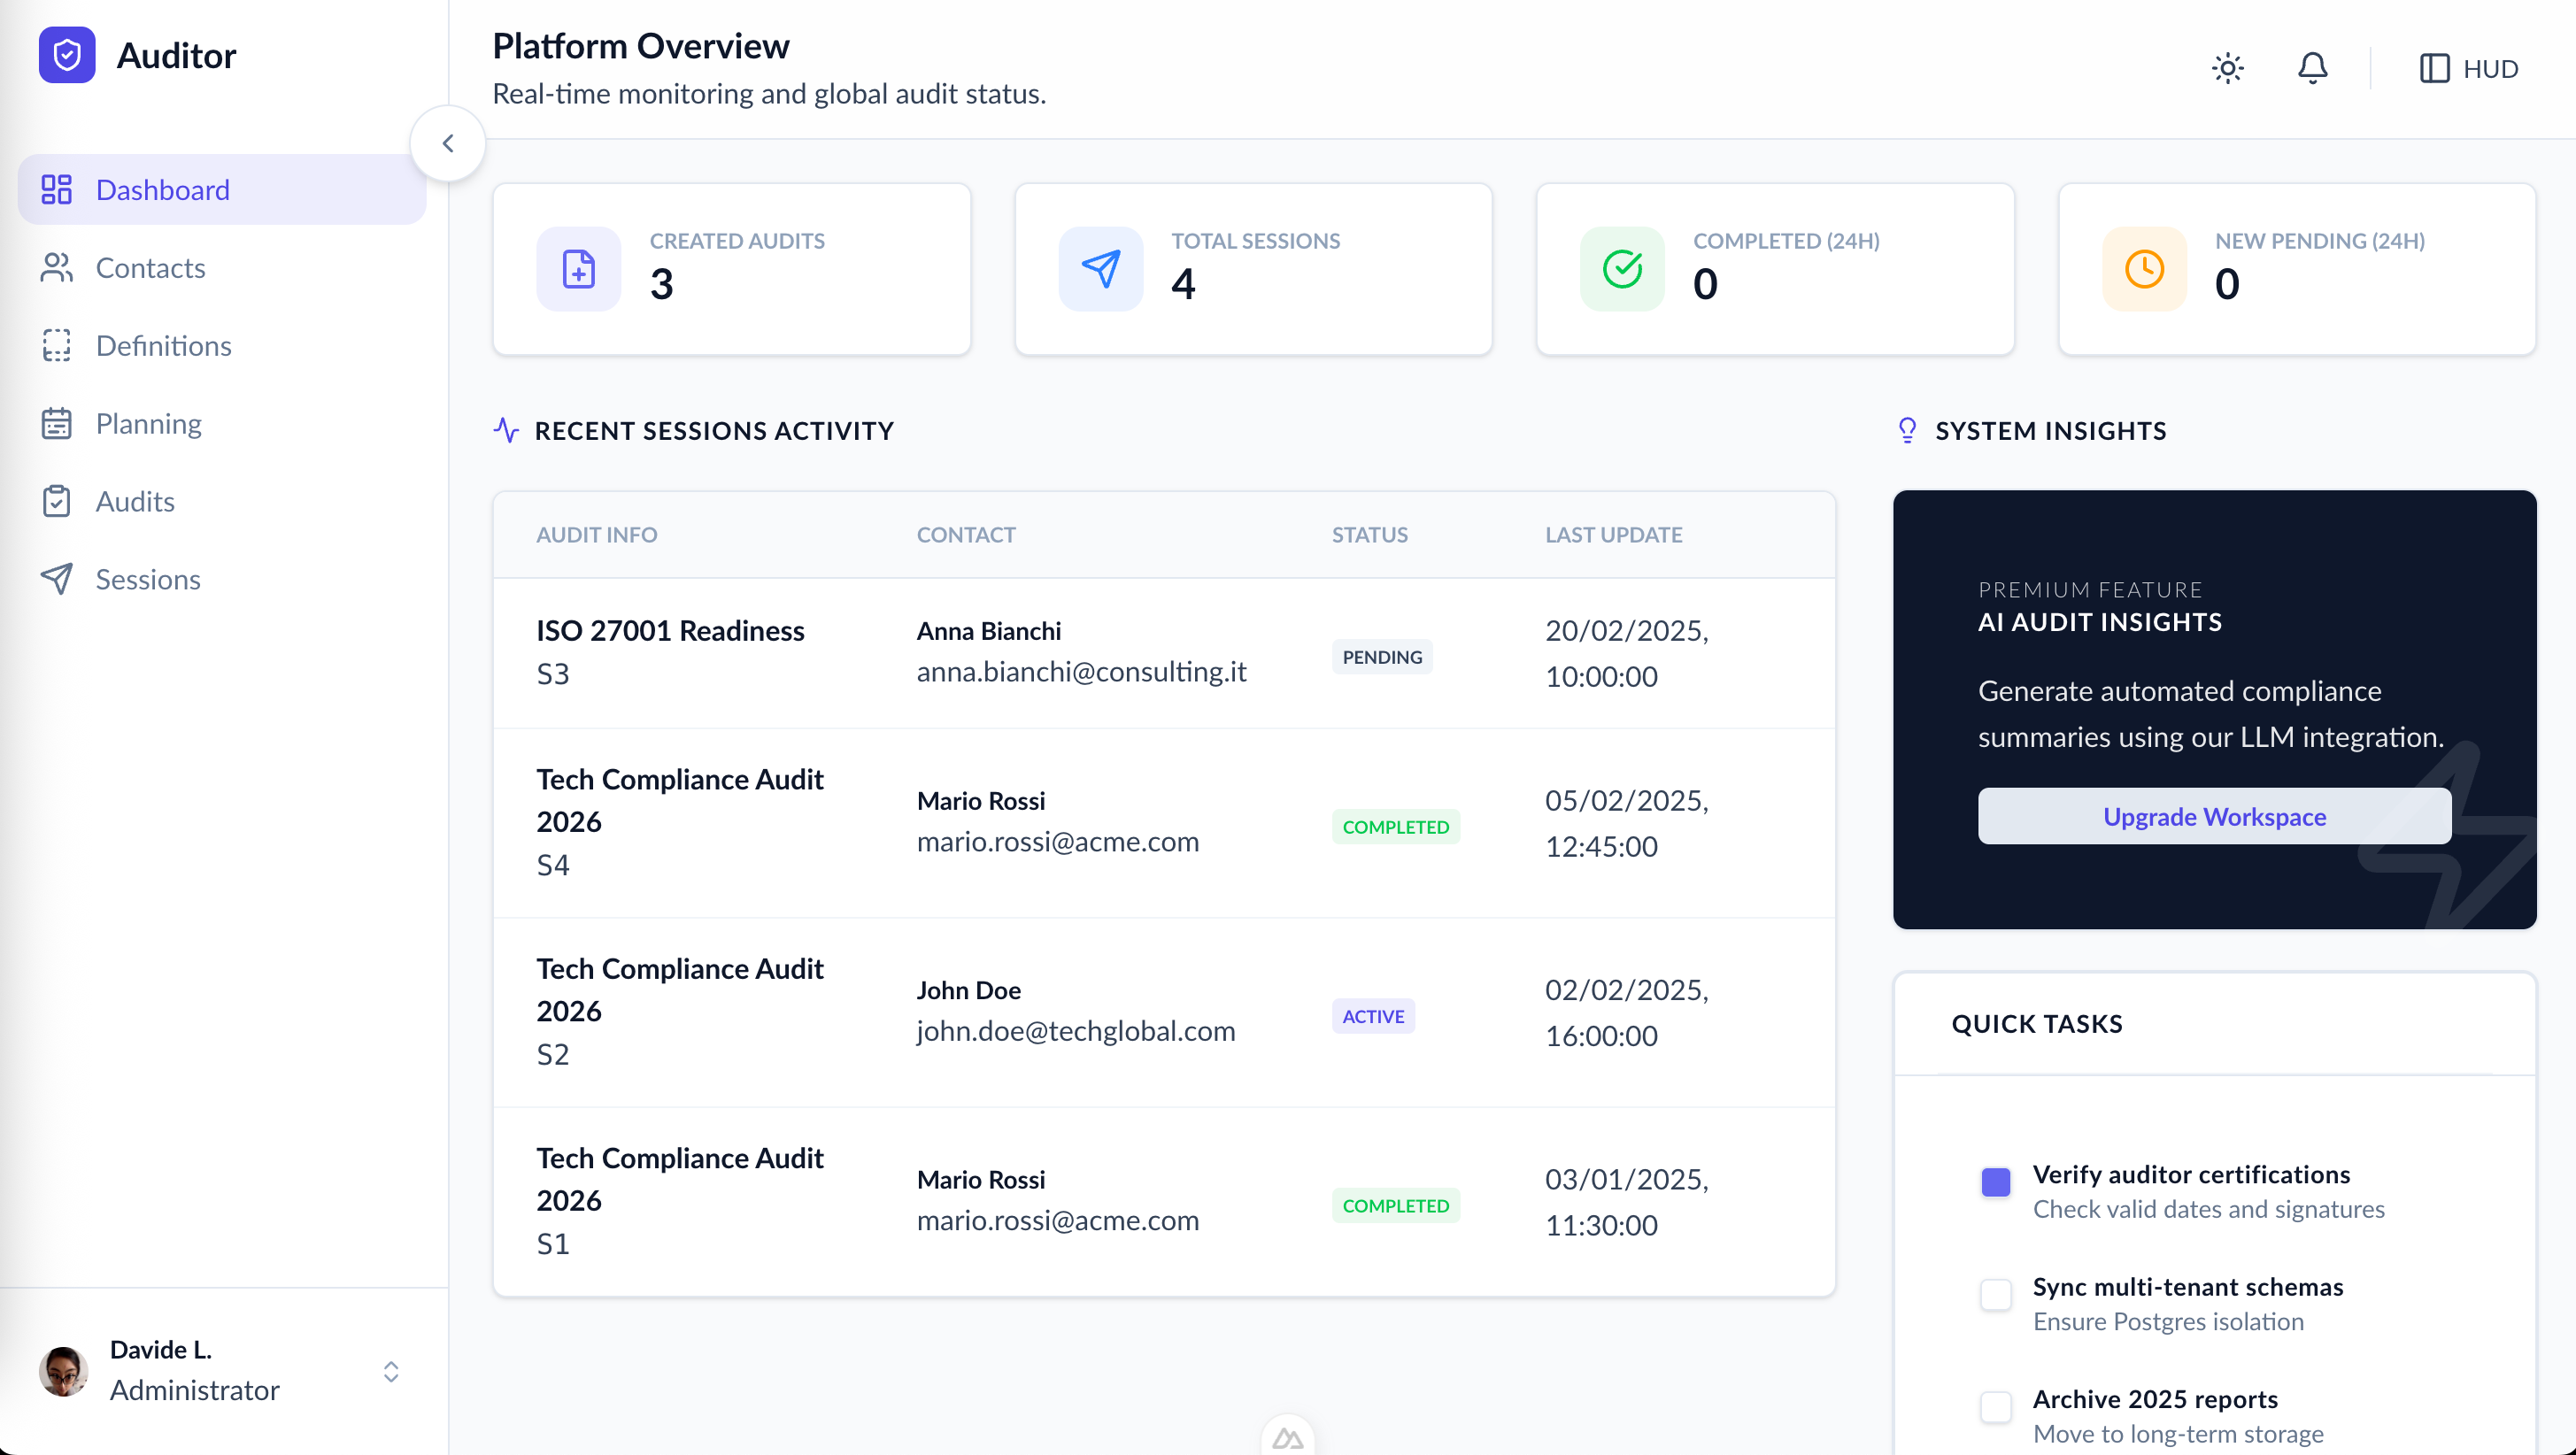
I documenti letti, e i file originali
L'archivio mostra i documenti che il sistema ha letto e indicizzato. Accanto ai frammenti usati per la ricerca restano i file originali, così la piattaforma serve anche da archivio documentale.
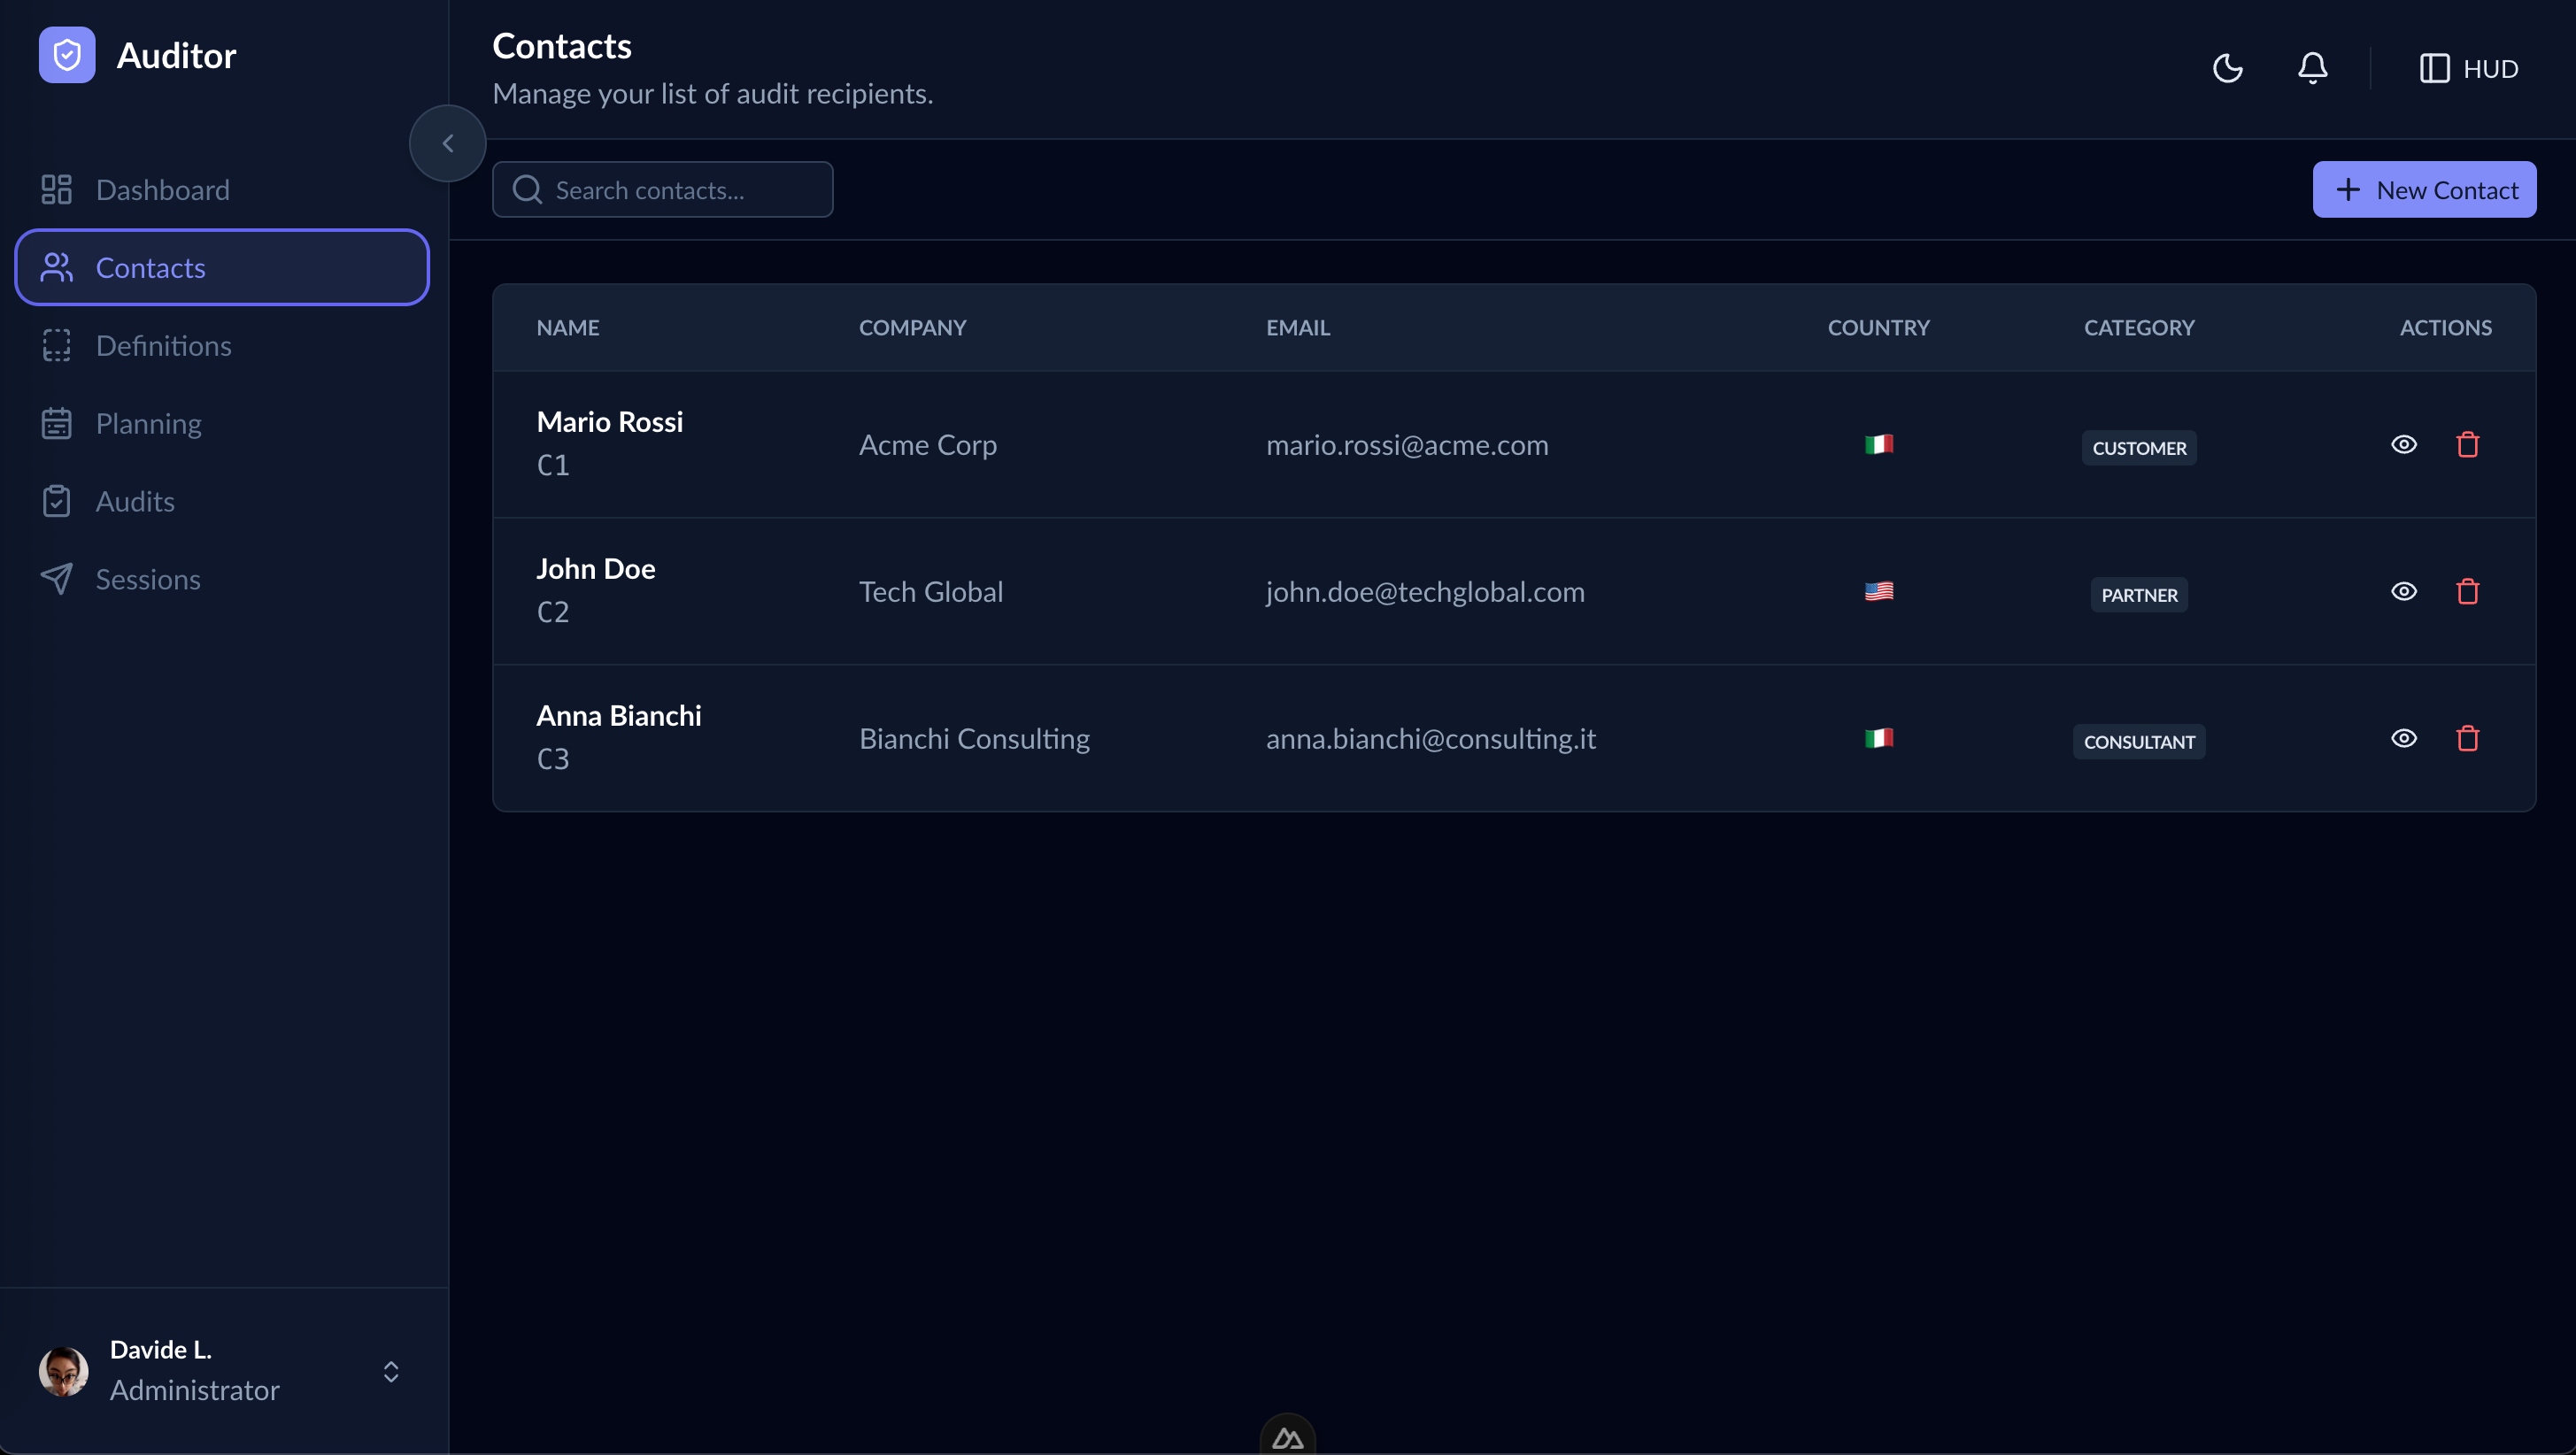
Chi vede cosa
Ogni ruolo vede la sua parte di documenti. Un documento riservato non entra nelle risposte date a chi non può consultarlo.
La conoscenza della tua azienda, a portata di domanda
Hai normative, procedure e manuali sparsi in archivi diversi? Raccontaci come sono organizzati e valutiamo insieme come renderli interrogabili.
Quanto tempo è servito?
Quattro mesi alla messa in produzione. Nella prima fase il sistema è in uso a 20 persone; gli altri utenti entrano dopo la fase 1.
Quanti documenti gestisce?
In tutto 225 GB: 20 GB di documentazione HSE in circa 30.000 file, 5 GB di sicurezza, 150 GB di operations e 50 GB di altri documenti.
Tutti vedono tutti i documenti?
No. Accessi e ruoli stabiliscono chi vede cosa, e l'agente risponde a ciascuno soltanto con i documenti che può consultare.
Il sistema conserva i file o solo i testi indicizzati?
Entrambi. I frammenti e i vettori servono alla ricerca; i file originali restano nel sistema, che all'occorrenza fa da archivio.
Su quale tecnologia si basa?
Sul backend Volcanic, il nostro framework Node.js costruito su Fastify, con LanceDB per la ricerca ibrida, BM25 e vettoriale, e Mastra per l'agente.
Quale modello AI usa, e dove vanno i documenti?
Oggi provider esterni con zero data retention, che non conservano quello che ricevono. Con Mastra il modello si cambia senza riscrivere il sistema, verso provider come OpenAI, Gemini o Claude oppure modelli interni e self-hosted su Ollama, vLLM o LM Studio.